현재 진행하고 있는 프로젝트에 기존 데이터와 신규 데이터 간 의미적 유사도를 검사하기 위해 Vector DB와 임베딩 모델을 적용하려 한다.
RAG에도 활용이 가능한 임베딩 모델과 Vector DB에 대해 알아보자.
Embedding Model (임베딩 모델)
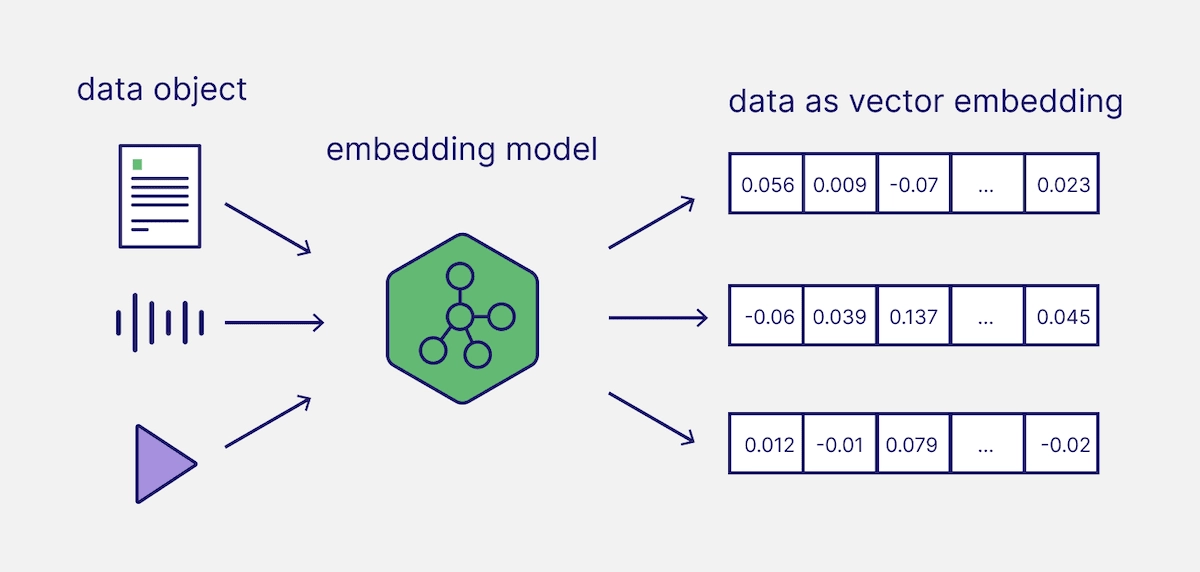
임베딩(Embedding)이란 텍스트, 이미지, 음성과 같은 비정형 데이터를 컴퓨터가 계산할 수 있는 고차원 벡터로 변환하는 작업을 말한다.
Dense Vector (고차원 벡터)
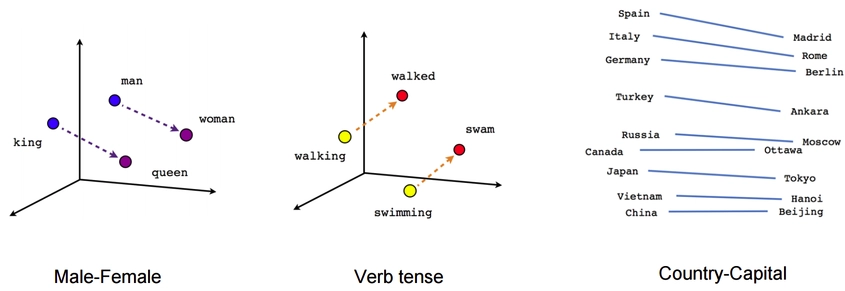
ex) [ 0.149, -0.512, 0.785, … ] (300개 이상의 차원)
데이터 간 유사도 판별을 위해 임베딩 모델은 텍스트, 이미지, 음성 등의 데이터를 고차원 벡터로 변환하여 N차원 공간 상의 방향으로 나타낸다.
고차원 벡터란, 연속적인 실수로 이뤄진 고차원의 벡터를 의미한다. 벡터 원소의 개수는 벡터 공간의 차수와 같다. 즉, 벡터에 존재하는 원소의 개수가 1536개라면 1536 차원의 공간에서 방향을 나타내는 수치라고 볼 수 있다.
아래 384 차원 벡터의 예시를 통해 형태를 이해할 수 있다. (단순한 예시임을 참고) [과일]로 묶을 수 있는 “사과”, “망고”와 [동물]로 묶을 수 있는 “고양이”, “개”의 벡터가 각각 가까운 값을 갖는다는 것을 어렴풋이 확인이 가능할 것이다.
"사과" -> [-0.0182, -0.0451, +0.0713, -0.0123, +0.0091, ...]
"망고" -> [-0.0195, -0.0423, +0.0699, -0.0150, +0.0078, ...]

"고양이" -> [+0.0512, +0.0234, -0.0310, +0.0601, -0.0411, ...]
"개" -> [+0.0498, +0.0211, -0.0295, +0.0623, -0.0389, ...]
이러한 고차원 벡터를 코사인 유사도를 통해 두 벡터 간의 차이를 -1, 1 사이의 실수로 나타낼 수 있다.
데이터를 고차원 벡터(방향)로 변환할 수 있다면 각 데이터의 유사도를 검증할 수 있다는 뜻이 된다. 임베딩 모델은 앞서 말한 작업을 한다.
코사인 유사도 (Cosine Similarity)
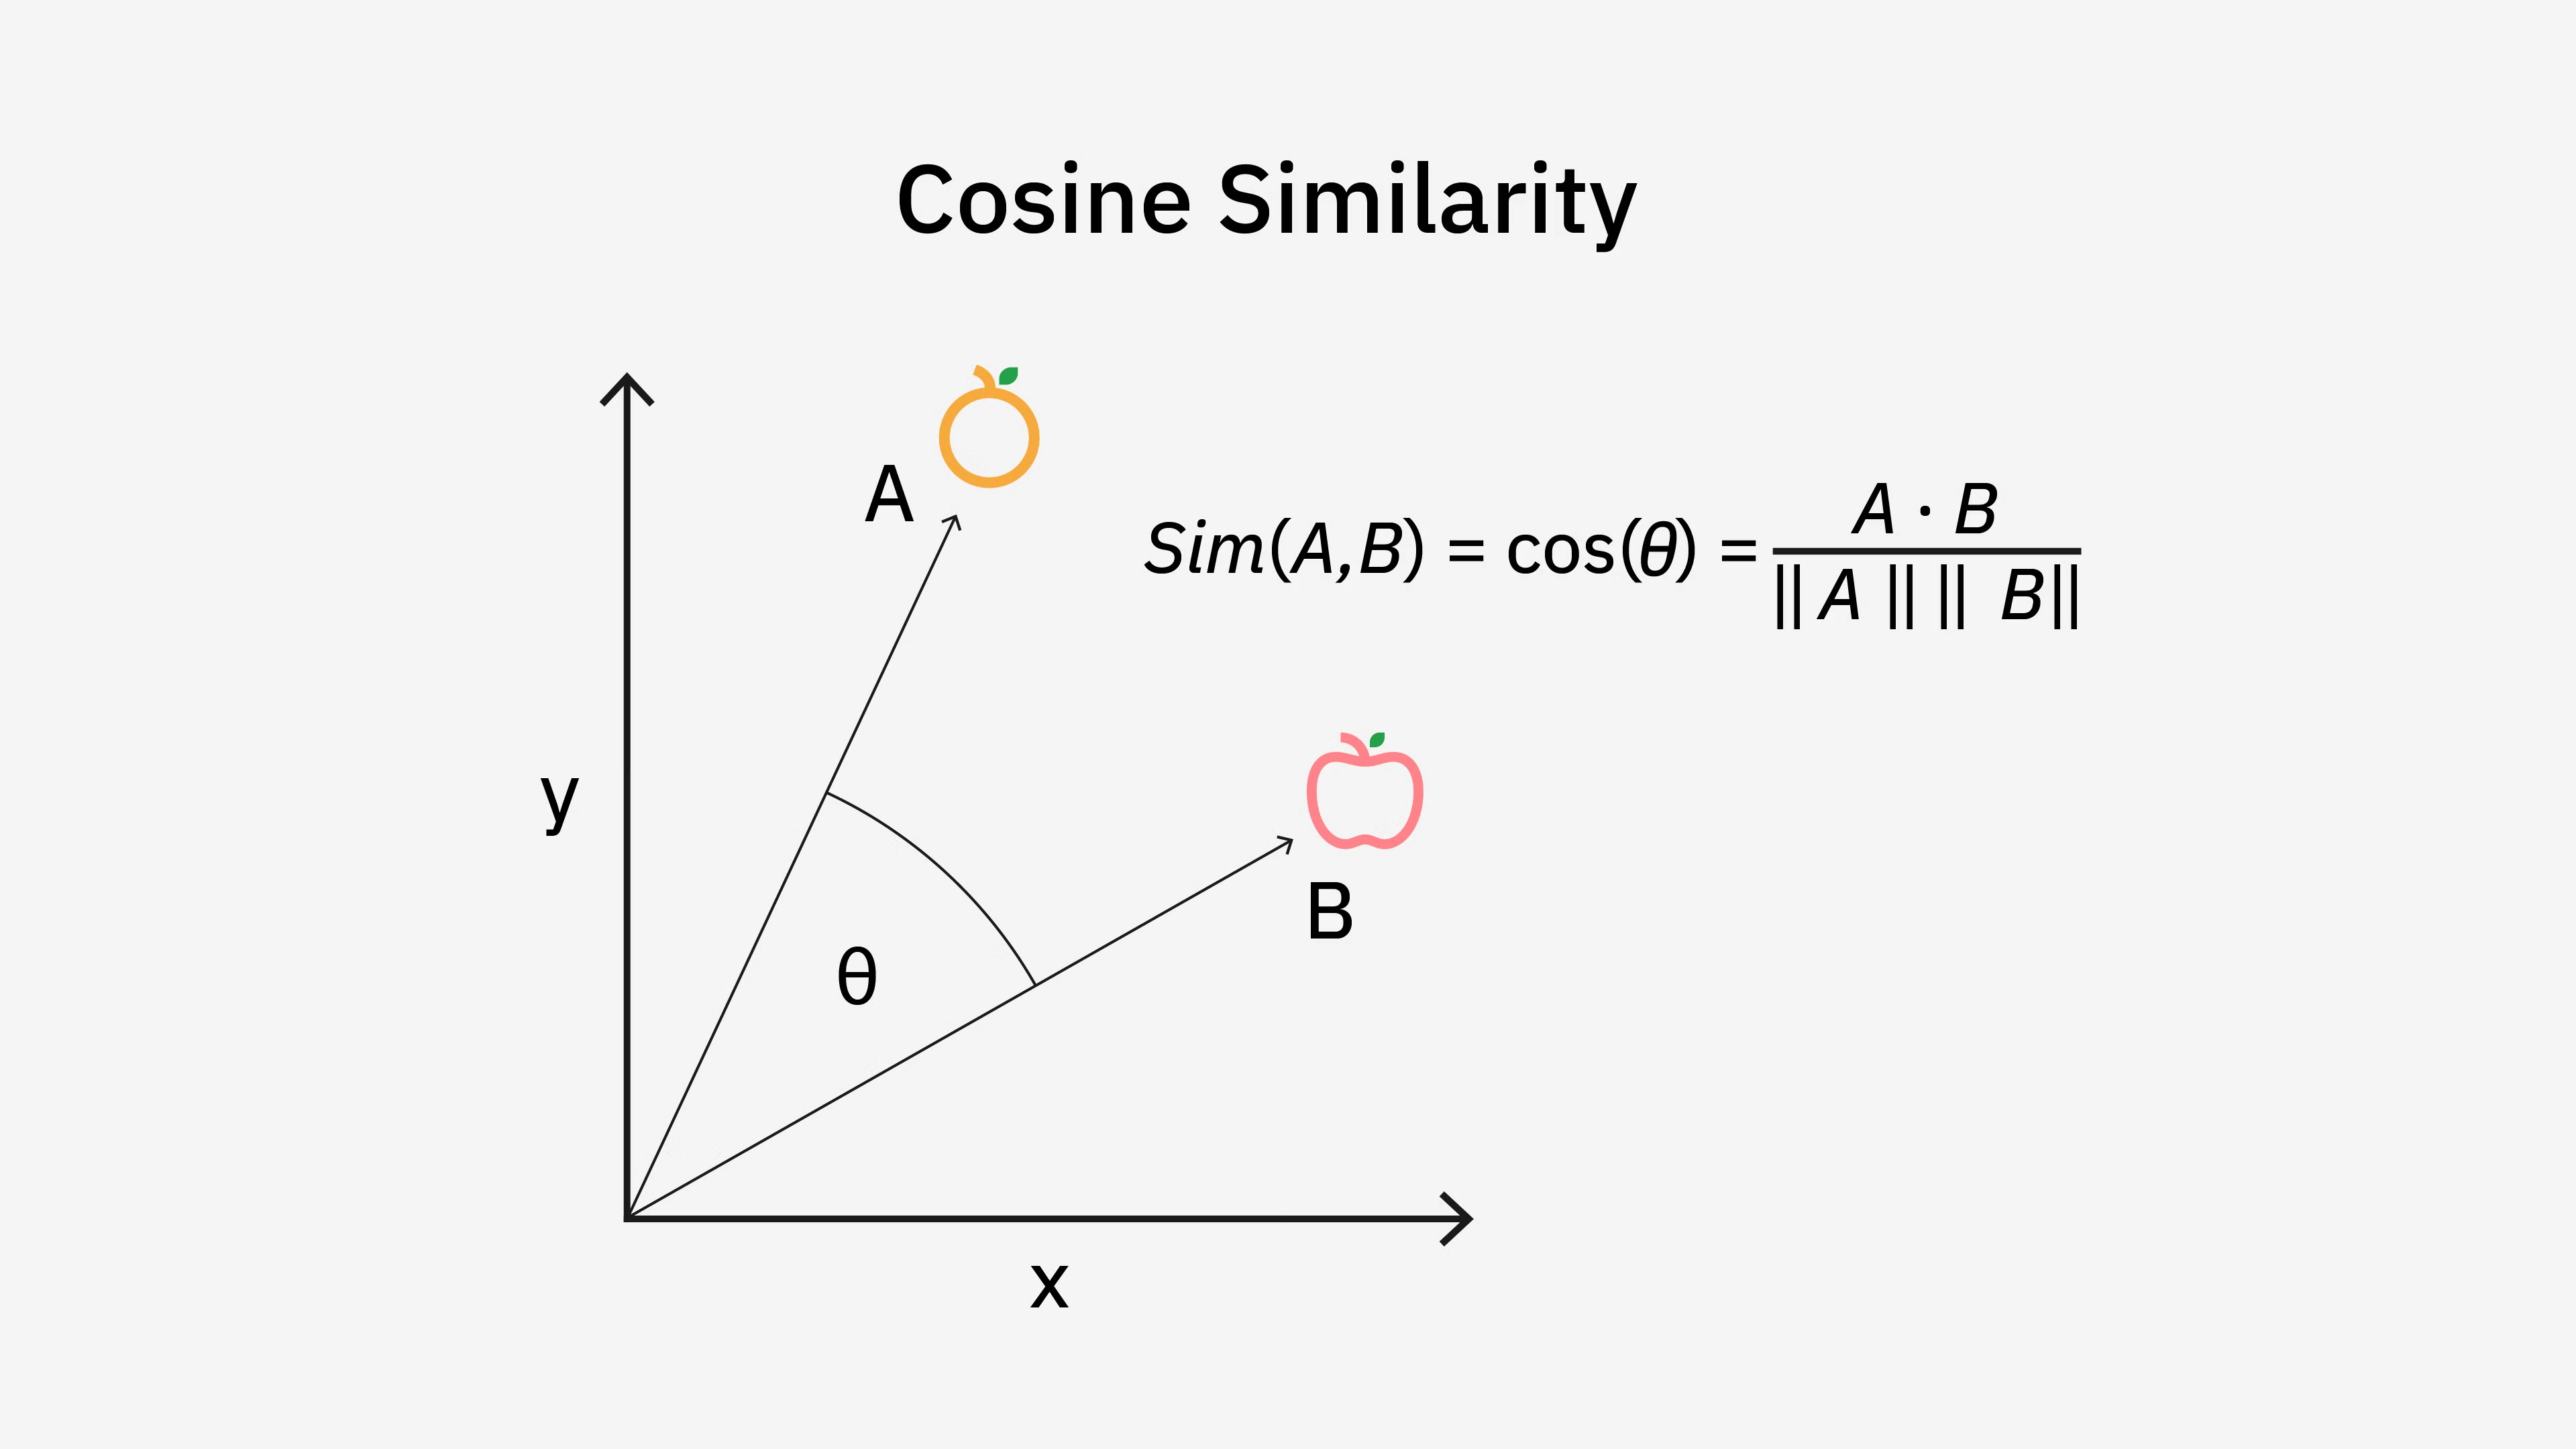
앞서 설명한 고차원 벡터의 유사도를 측정하는 방법이다. 간단히 말해 두 벡터가 얼마나 같은 방향을 가리키고 있는가에 대해 가장 적절한 지표가 코사인 유사도라고 할 수 있다.
(자세한 수학적인 설명은 생략하도록 한다!)
임베딩 (Embedding)
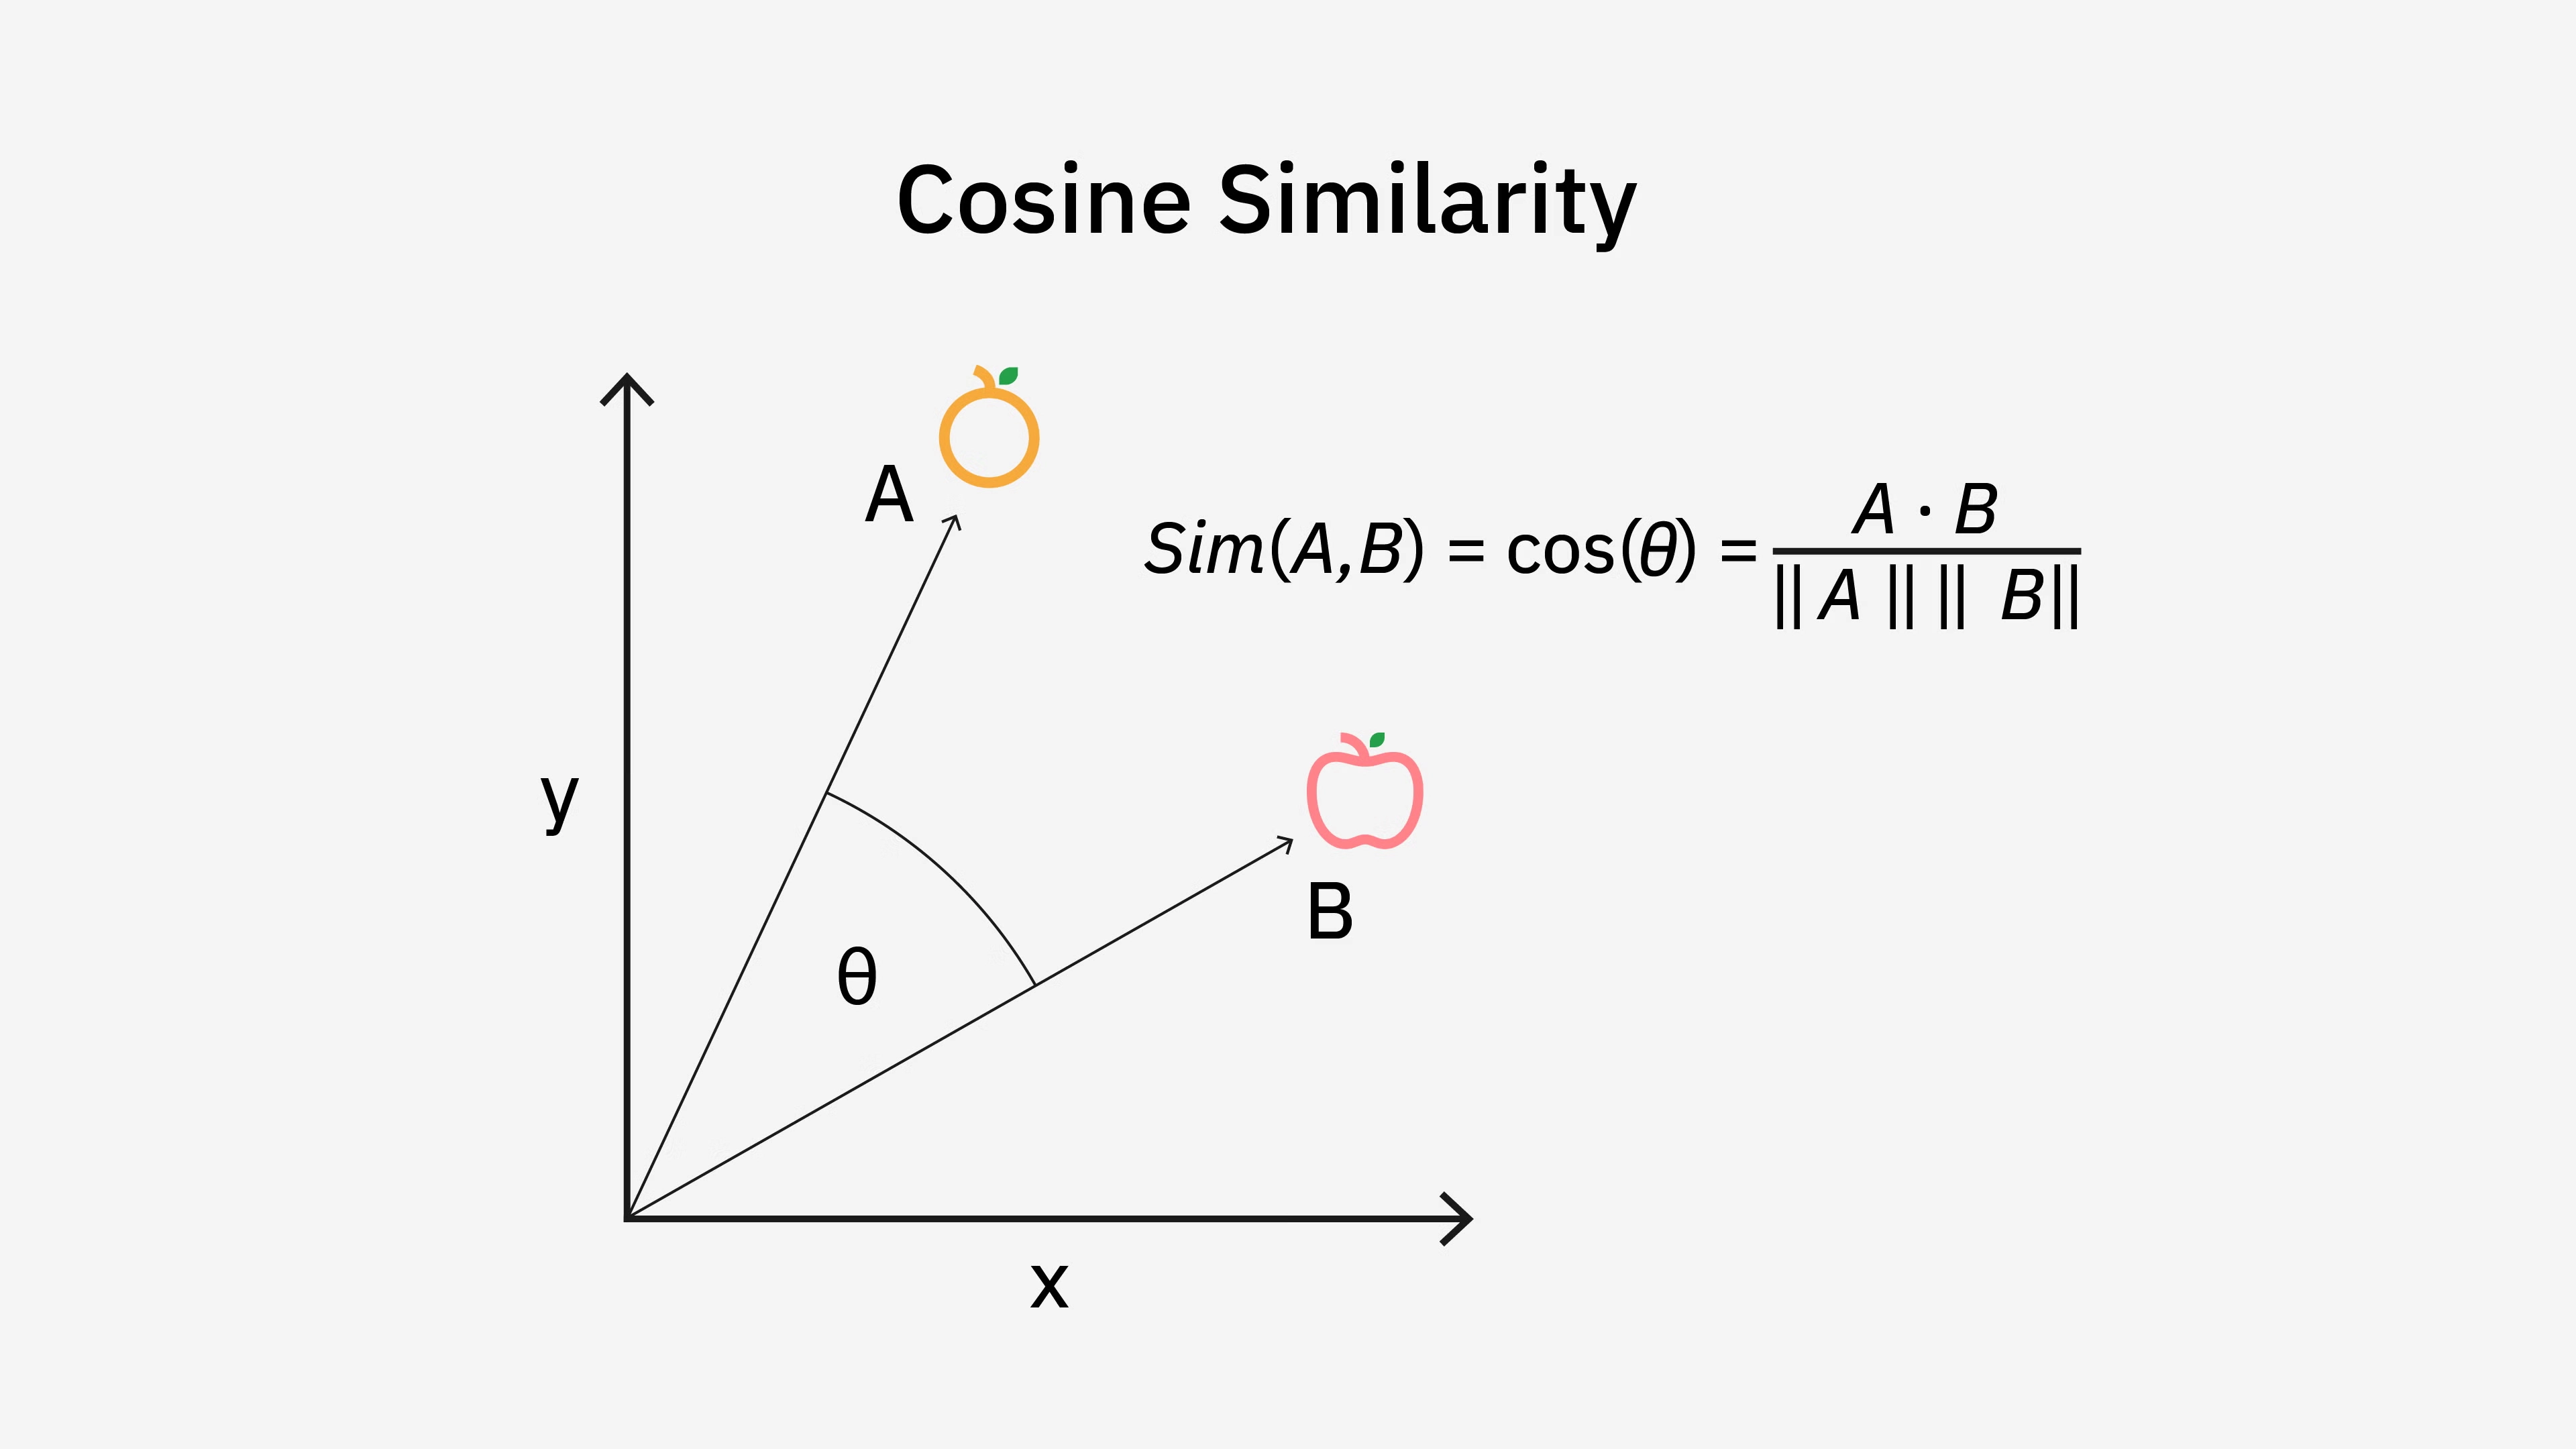
임베딩 모델이 텍스트를 고차원 벡터로 변환하는 과정은 크게 3단계로 나뉜다.
- [입력 문장] -> 토크나이저(Tokenizer) -> 임베딩 룩업 테이블(Lookup Table) -> 문맥 신경망 연산 -> [최종 Dense Vector]
위의 단계에서 주목할 점은 아래와 같다.
- 모델이 학습 과정에서 미리 구축해 둔 고유한 단어 사전(Vocabulary)을 참조하여, 각 토큰을 사전의 고유 번호인 정수 ID(Token ID)로 변환한다.
- 토큰 ID를 일종의 인덱스(Key)처럼 사용하여, 기존에 존재하는 룩업 테이블의 해당 행에서 기본 벡터 값(Value)을 빠르게 꺼내오는(Lookup) 작업을 수행한다.
- 독립된 초기 단어 벡터들이 트랜스포머 신경망을 거치며 앞뒤 문맥을 반영하여, 다의어도 문맥에 맞는 고유한 의미를 갖는 최종 Dense Vector로 변환된다.
결과적으로 임베딩 모델은 단순한 글자 매칭을 넘어, 단어 사전 기반의 빠른 탐색과 문맥 연산을 통해 인간의 언어가 지닌 '실제 의미'를 N차원의 좌표 공간에 정교하게 배치하는 역할을 완성한다.
이러한 벡터 값을 저장하기 위해 Vector DB가 사용된다.
Vector DB란
앞서 살펴본 임베딩 모델을 통해 변환된 수많은 고차원 Dense Vector를 효율적으로 저장/관리하고, 특정 벡터와 의미적으로 가장 가까운 데이터를 초고속으로 검색하기 위해 특화된 데이터베이스다.
- 벡터 DB 종류
| 제품명 | 아키텍처 계열 | 주요 특징 및 장단점 | 실무 도입 추천 상황 |
| pgvector | RDB 확장 (PostgreSQL) | 기존 RDB의 트랜잭션(ACID)과 조인 활용 시스템 복잡도 증가 없음 |
백엔드(Spring Boot 등) 환경에서 인프라 추가 없이 빠르게 RAG 구축 시 (1천만 건 이하) |
| Qdrant | 전용 벡터 DB | Rust 기반으로 리소스 소모가 적고 매우 빠름 단일 노드부터 분산까지 세팅 유연 |
독립적인 벡터 검색 마이크로서비스(MSA) 구축 및 쾌적한 오픈소스 DB 필요 시 |
| Milvus | 전용 벡터 DB | 대규모 분산 아키텍처에 특화된 엔터프라이즈급 의존성(MinIO, etcd)이 많아 무거움 |
수억 건 이상의 거대한 데이터와 높은 수준의 분산 클러스터링이 필요할 때 |
| Chroma | 전용 벡터 DB | Python/JS 생태계 친화적 로컬에서 띄우고 테스트하기 극도로 쉬움 |
소규모 RAG 아키텍처 구성 및 가벼운 AI 프로토타이핑(PoC) 진행 시 |
| Pinecone | 완전 관리형 (SaaS) | 인프라 관리(Ops) 제로, 연동이 매우 쉬움 데이터/트래픽 증가 시 월 비용이 가파르게 상승 |
인프라 관리 인력이 없고 최단기간 내 프로덕션 런칭이 최우선일 때 |
| Redis (RediSearch) | 인메모리 (캐시) | 램(RAM) 기반이라 검색 속도가 압도적임 대용량 시 메모리 인프라 유지 비용이 극심함 |
기존 Redis를 활용하면서 실시간 추천 등 밀리초 단위의 극단적인 속도가 필요할 때 |
'IT > AI' 카테고리의 다른 글
| [AI] 유사도 판정 파이프라인 임베딩 모델 선정 (jhgan/ko-sroberta-multitask) (0) | 2026.09.23 |
|---|