아키텍처 다이어그램
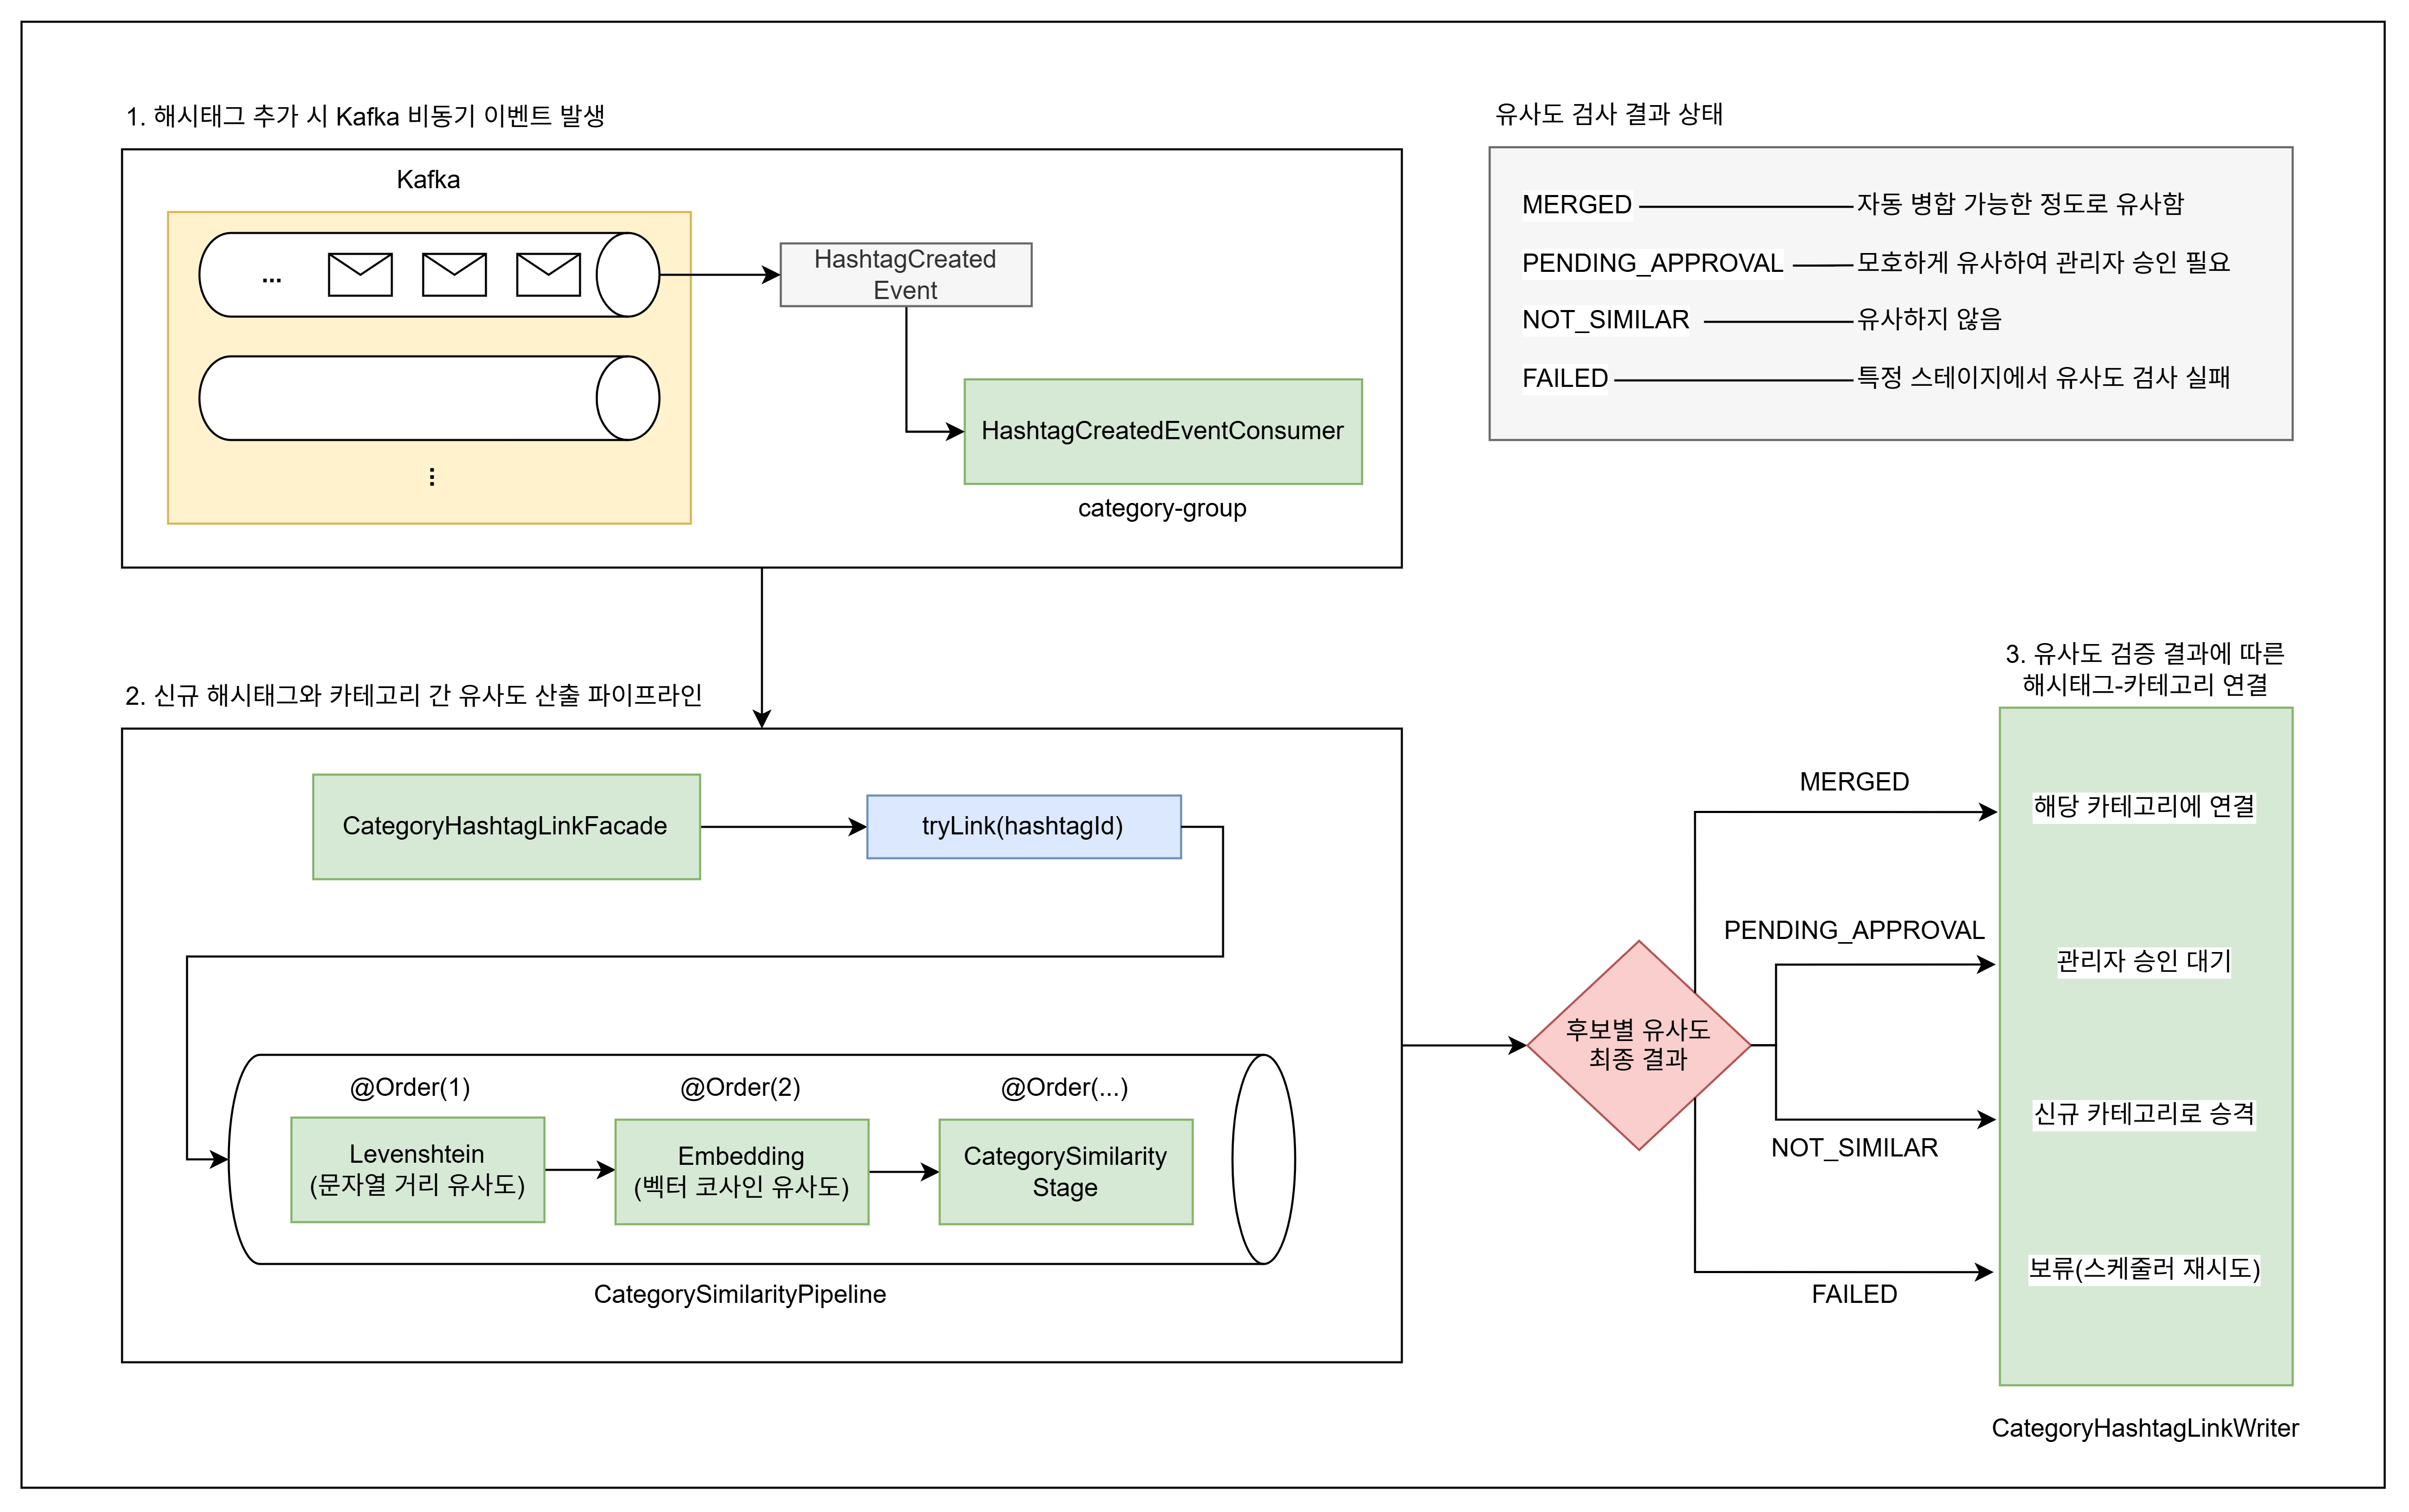
개요
해시태그가 새로 생성되면(HashtagCreatedEvent), 기존 카테고리들과의 유사도를 계산해 즉시 병합 / 관리자 승인 대기 / 신규 카테고리 생성 중 하나로 연결하는 파이프라인.
- 진입점: HashtagCreatedEventConsumer → CategoryHashtagLinkFacade.tryLink(hashtagId)
- 실제 DB 반영(연결/신규 카테고리 승격)은 CategoryHashtagLinkWriter가 담당 - Facade는 조회+파이프라인 호출까지만
- 유사도 계산 방식(Levenshtein/임베딩/LLM)은 언제든 교체·추가·삭제 가능하도록 설계됨
진입 이벤트 발행 (Outbox 패턴)
HashtagCreatedEvent/CategoryCreatedEvent는 생성 즉시 Kafka로 발행되는 게 아니라 Outbox 패턴을 거침 - dual-write(DB 커밋은 성공했는데 발행만 유실되는 문제) 방지 목적
- 해시태그/카테고리 생성과 같은 트랜잭션 안에서 OutboxRepository에 이벤트를 먼저 기록(PENDING)
- OutboxRelay(3초 주기, BATCH_SIZE=10, MAX_ATTEMPT=5)가 별도로 폴링해서 실제 Kafka 발행 - 즉 "DB에 생성됨"과 "이벤트가 실제로 발행됨" 사이에 최대 3초 갭이 하나 더 있음(파이프라인 전체 e2e 지연 계산 시 빠뜨리면 안 됨)
- Outbox 자체의 알려진 갭(코드에 TODO로 남음):
- 릴레이가 여러 인스턴스로 뜨는 경우 claim 쿼리(FOR UPDATE SKIP LOCKED) 없이는 중복 발행 가능성 있음
- 발행 처리 중 죽으면 PROCESSING 상태에 멈춘 이벤트를 복구하는 로직이 없음
- 매칭되는 publisher가 없는 이벤트 타입은 재시도 없이 즉시 실패 처리(데드레터)
파이프라인 구성 요소
스테이지 (Strategy 패턴)
- 포트
// 유사도 판단 파이프라인의 스테이지, 기술적인 구현은 추상화
// candidates로 받은 병합 후보 각각에 대해 판정을 내려 반환한다(후보 하나당 결과 하나)
public interface CategorySimilarityStage {

    List<CategoryCandidateResult> evaluate(Hashtag hashtag, List<Category> candidates);
}
- 구현체
- LevenshteinCategorySimilarityStage(@Order(1), 문자열 거리, 빠름)
- EmbeddingCategorySimilarityStage(@Order(2), 벡터 코사인 유사도)
- 실제 임베딩 계산은 EmbeddingClientImpl이 Feign(EmbeddingFeignClient)으로 embedding-service를 호출
- LlmCategorySimilarityStage(@Order(3))
- 스켈레톤만 존재, 클래스 전체가 주석 처리돼 비활성 상태 (Bean으로 등록 안 됨)
- 실행 순서: 각 구현체의 @Order로 결정 — 빠르고 단순한 것 → 느리고 정확한 것 순
- 임계값은 Stage마다 상수(MERGE_THRESHOLD, PENDING_APPROVAL_THRESHOLD)를 따로 둠
- 파이프라인은 스테이지의 기술적 구현(알고리즘/외부 호출 여부 등)에 전혀 관여하지 않음
카테고리 벡터 계산 파이프라인 (Embedding 스테이지 전제조건)
EmbeddingCategorySimilarityStage가 코사인 유사도를 계산하려면 카테고리마다 벡터가 미리 계산돼 있어야 함. (해시태그 벡터와 계산 방식이 비대칭적)
해시태그 벡터 카테고리 벡터
| 계산 시점 | Embedding 스테이지 실행 중 lazy(그 자리에서) | 카테고리 생성 시 비동기(Kafka 이벤트) |
| 트리거 | EmbeddingCategorySimilarityStage.ensureHashtagVectorExists() | CategoryCreatedEventConsumer → CalculateCategoryVectorUseCase#calculate(categoryId) |
| 실패 시 | 그 호출 자체가 Failed로 즉시 반영 | Kafka 컨슈머 예외 → 재시도(3회) → 실패하면 CategoryVectorRecoveryScheduler(10초 주기, BATCH_SIZE=20, findActiveIdsWithoutVector)가 재계산 |
- 카테고리는 admin API로 직접 생성되든, promoteToNewCategory()로 해시태그가 신규 승격되든 상관없이 생성 시 항상 CategoryCreatedEvent가 발행됨(Outbox) → 이 이벤트가 벡터 계산을 트리거
- 막 생성된 카테고리는 벡터 계산이 아직 안 끝났을 수 있음 - 그 상태에서 다른 해시태그가 이 카테고리를 후보로 Embedding 스테이지에서 평가하면 Failed("카테고리 벡터 없음")가 남 (일시적 상태, CategoryVectorRecoveryScheduler가 해소)
결과 타입 (Hierarchy)
CategoryMatchResult (sealed interface, domain.model)
타입 의미
| Merge | 즉시 병합 가능할 만큼 유사함 |
| PendingApproval | 병합 가능성은 있으나 애매함 → 관리자 승인 대기 |
| NotSimilar | 이 스테이지 기준으론 유사한 카테고리 없음 (정상 판단) |
| Failed | 스테이지 실행 자체가 실패함 (타임아웃/예외 등, 비정상 — "유사하지 않음"과는 다름) |
결과 결합 규칙 (도메인 규칙)
CategoryMatchResult.combineWith(next) — 우선순위 규칙 자체를 타입에 캡슐화
- Merge — 찾는 즉시 확정 (최우선, 이후 스테이지 호출 안 함)
- PendingApproval — 한 번 찾으면 이후 어떤 결과가 와도(Merge 제외) 계속 유지됨
- NotSimilar / Failed — 서로 우선순위 없이 최신 스테이지 결과로 자유롭게 갱신 (뒤 스테이지가 더 정확한 방법이므로 그 결론을 신뢰)
- 임계값은 Stage마다 상수(MERGE_THRESHOLD, PENDING_APPROVAL_THRESHOLD)를 따로 둠
오케스트레이터 (Pipeline)
- CategorySimilarityPipeline
@Component
@RequiredArgsConstructor
public class CategorySimilarityPipeline {

    // 순서는 각 구현체의 @Order로 결정 - 스테이지를 추가/제거/재정렬해도 이 클래스는 안 바뀜
    private final List<CategorySimilarityStage> stages;

    public List<CategoryCandidateResult> resolve(Hashtag hashtag, List<Category> candidates) {
        //...
    }
}
- 후보(카테고리)별로 독립적인 누적 결과(Map<categoryId, CategoryMatchResult>)를 추적
- "해시태그 전체에 대한 단일 결과"가 아님
- 각 스테이지는 아직 확정 안 된(remaining) 후보만 대상으로 실행됨
- 이번 스테이지 결과를 combineWith로 누적에 접고(fold), 그 결과로 Merge/PendingApproval이 확정된 후보는 remaining에서 빠져 다음 스테이지로 안 넘어감
- 후보 단위 조기 확정(전체 조기 종료)가 아님
- remaining이 비거나 모든 스테이지를 다 돌면 종료, 후보별 최종 누적 결과를 반환
- 후보마다 결과가 다를 수 있어 한 해시태그가 서로 다른 카테고리 여러 개에 동시에(서로 다른 match_type/status로) 연결되는 것도 가능
- 판단 규칙(우선순위)에는 관여하지 않고 "실행 + 누적"만 담당
- 포트(CategorySimilarityStage)를 들고 있어서 application 계층에 위치
실제 연결 (Pipeline 밖, Facade/Writer가 담당)
- CategoryHashtagLinkFacad : Pipeline을 호출하고, 결과를 CategoryHashtagLinkWriter에 넘겨 실제 DB에 반영
@Service
@RequiredArgsConstructor
public class CategoryHashtagLinkFacade implements LinkHashtagToCategoryUseCase {

    private final CategoryCommandRepository categoryCommandRepository;
    private final HashtagCommandRepository hashtagCommandRepository;
    private final CategorySimilarityPipeline categorySimilarityPipeline;
    private final CategoryHashtagLinkWriter categoryHashtagLinkWriter;

    @Override
    public void tryLink(UUID hashtagId) {
        Hashtag hashtag = hashtagCommandRepository.findById(hashtagId)
                .orElseThrow(() -> new BusinessException(CategoryErrorCode.HASHTAG_NOT_FOUND));
        List<Category> categories = categoryCommandRepository.findAllActive();

        List<CategoryCandidateResult> candidateResults = categorySimilarityPipeline.resolve(hashtag, categories);

        categoryHashtagLinkWriter.applyResults(hashtagId, hashtag, candidateResults);
    }
}
- 후보(카테고리)별 결과를 순회하며 Merge/PendingApproval인 후보는 전부 그 카테고리에 연결
- linkIfAbsent : ON CONFLICT DO NOTHING이라 중복 연결 시도해도 안전
- 후보가 여러 개면 여러 카테고리에 동시 연결됨
- 순회 후 판단(해시태그 전체 기준)
조건 처리
| 하나라도 Merge/PendingApproval로 매칭됨 | (이미 위에서 연결 완료, 추가 처리 없음) |
| 매칭 없음 + 실패(Failed)도 없음 | 신규 카테고리 생성 후 MERGED로 연결 |
| 매칭 없음 + 하나라도 Failed 있음 | 카테고리 연결 없이 보류 (스케줄러가 재시도 대상으로 나중에 다시 처리) |
'IT > 트러블슈팅' 카테고리의 다른 글
| [TroubleShooting] M2M, MSA 환경에서의 내부 통신 고민 (0) | 2026.08.06 |
|---|---|
| [Spring boot] 낙관락, 비관락 의사결정 기준에 대해 (0) | 2026.07.08 |
| [Spring boot] Soft-Delete와 Unique 제약조건 고찰 (0) | 2026.07.07 |
| [Spring boot] CSRF 토큰과 Session 생성 타이밍 불일치 (1) | 2026.04.14 |
| [Spring boot] 사용자의 리소스 접근 권한에 대해 (0) | 2025.04.10 |